文章摘要:Abstract
•
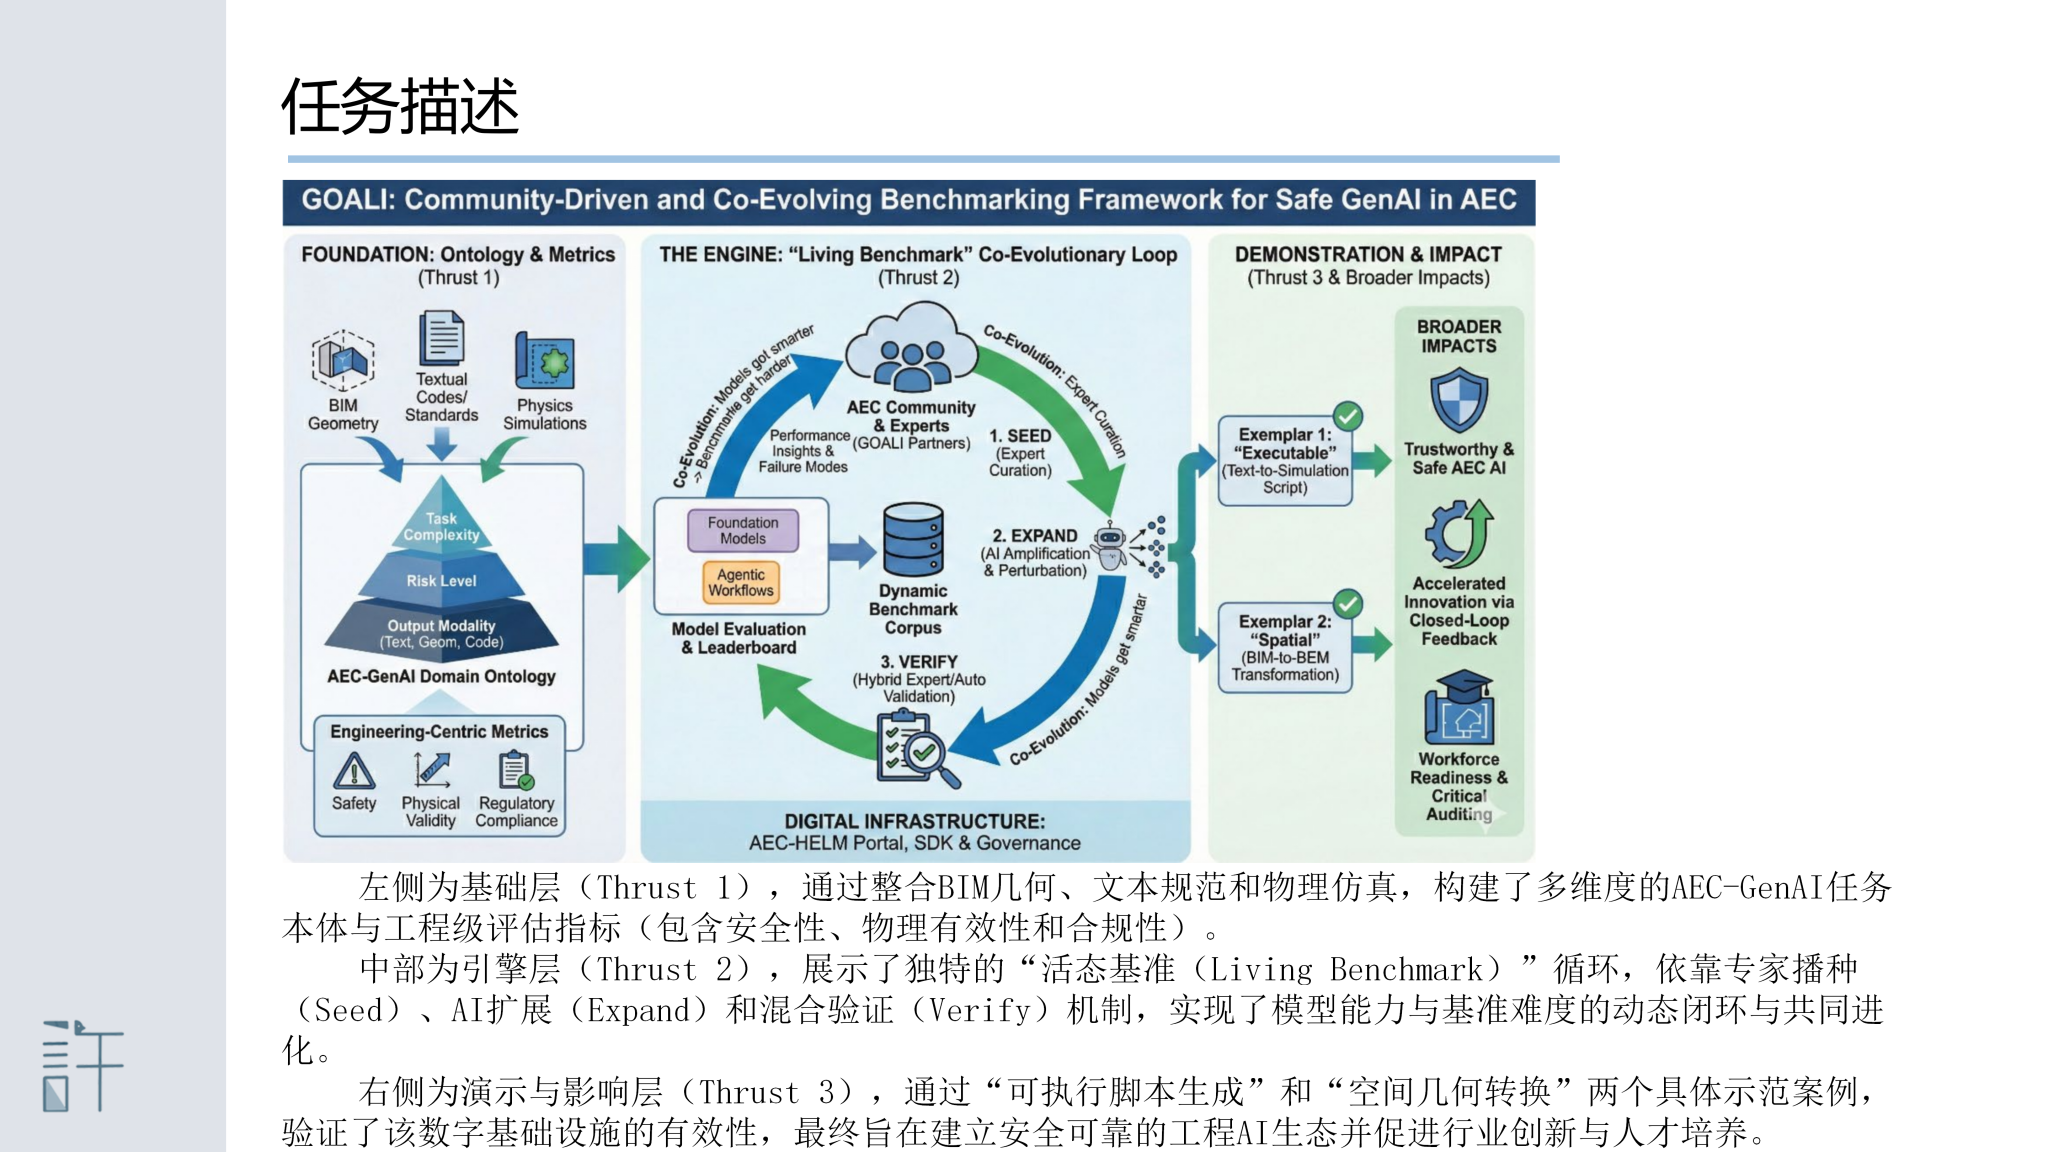
Architecture, Engineering, and Construction (AEC)
•
生成式
AI
的
Living B
enchmark
•
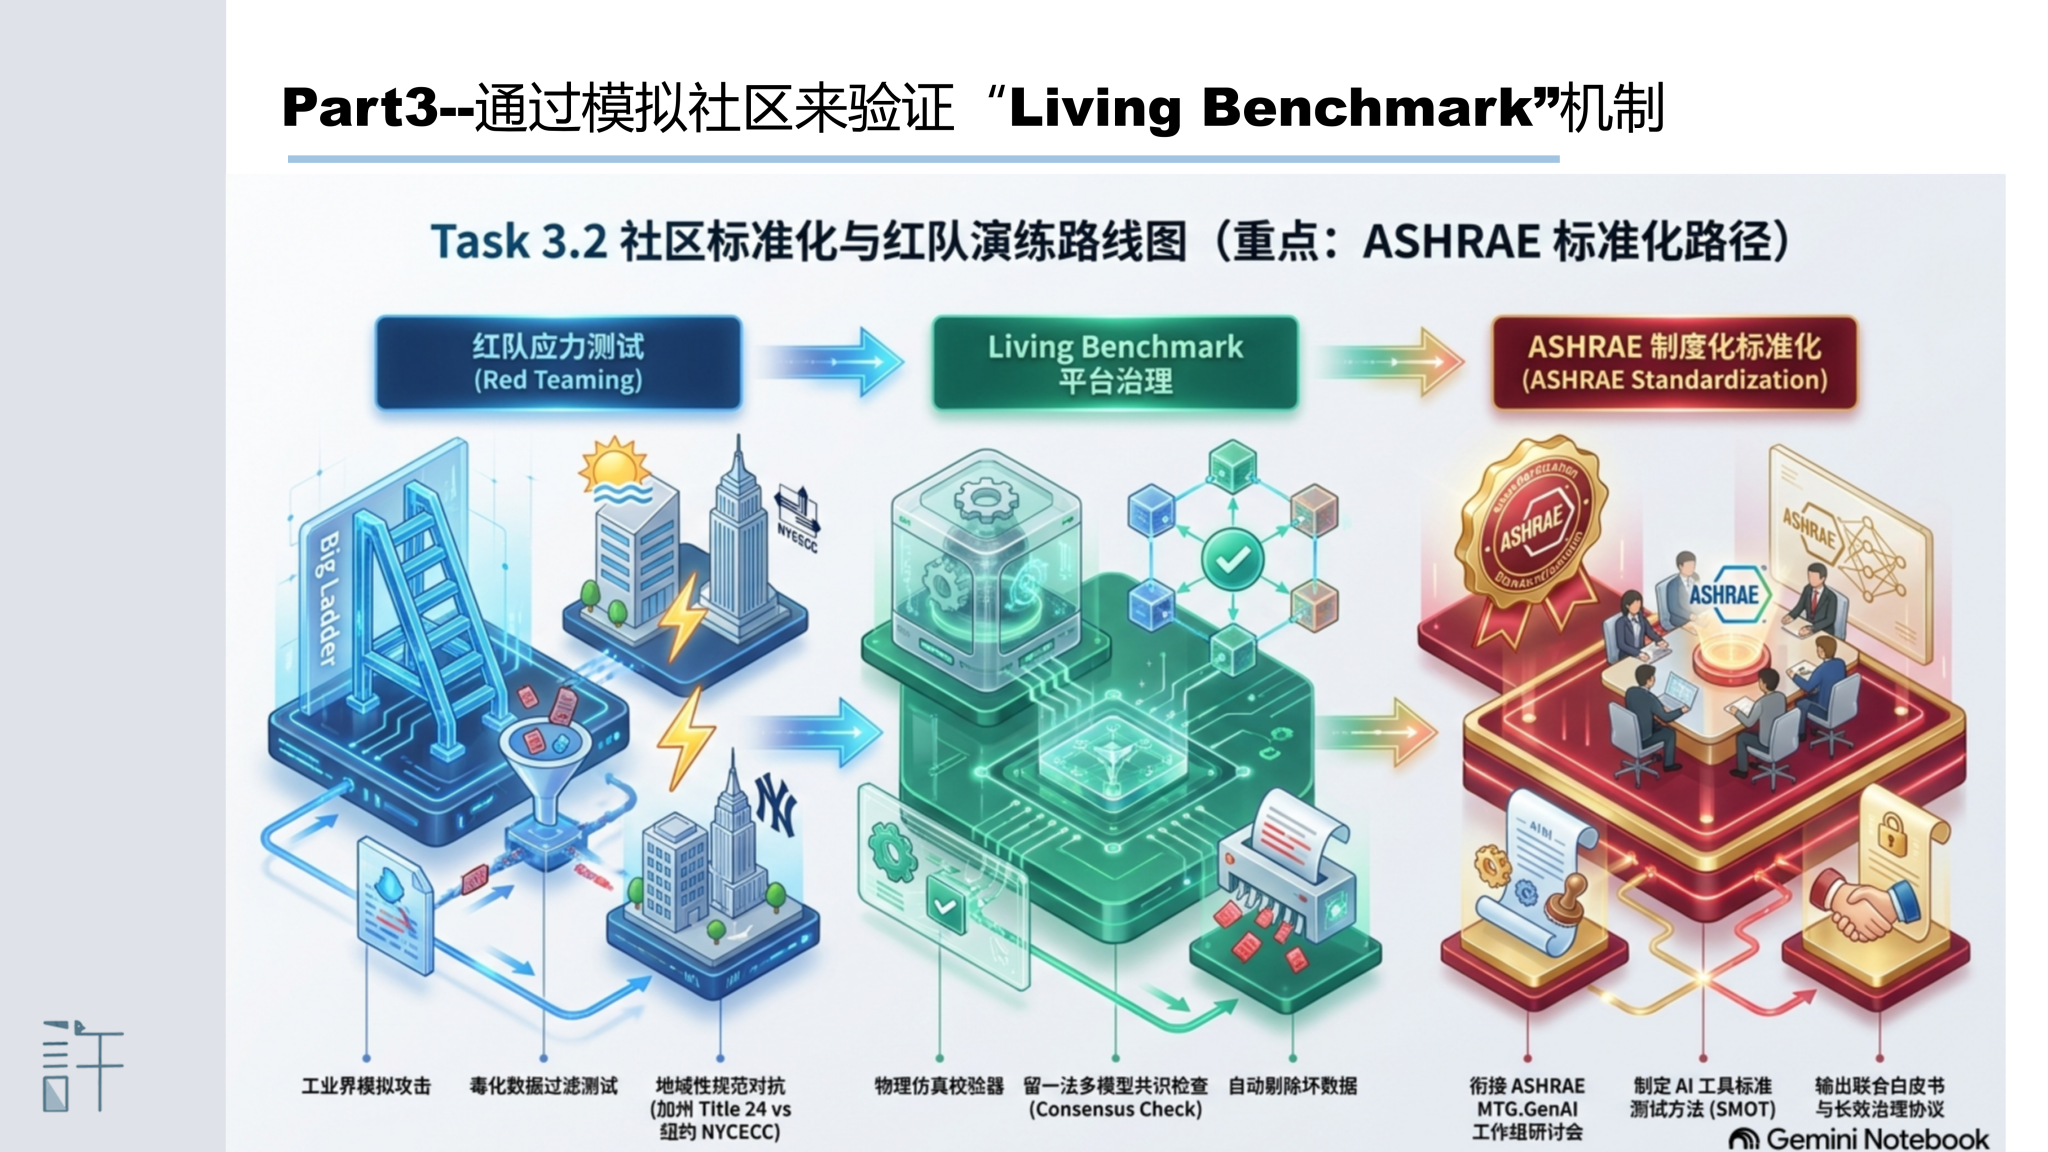
Seed-Expand-Verify(
种子-扩展-验证)
没有统一标准的危害
对工程实践者(工程师 / 建筑企业):
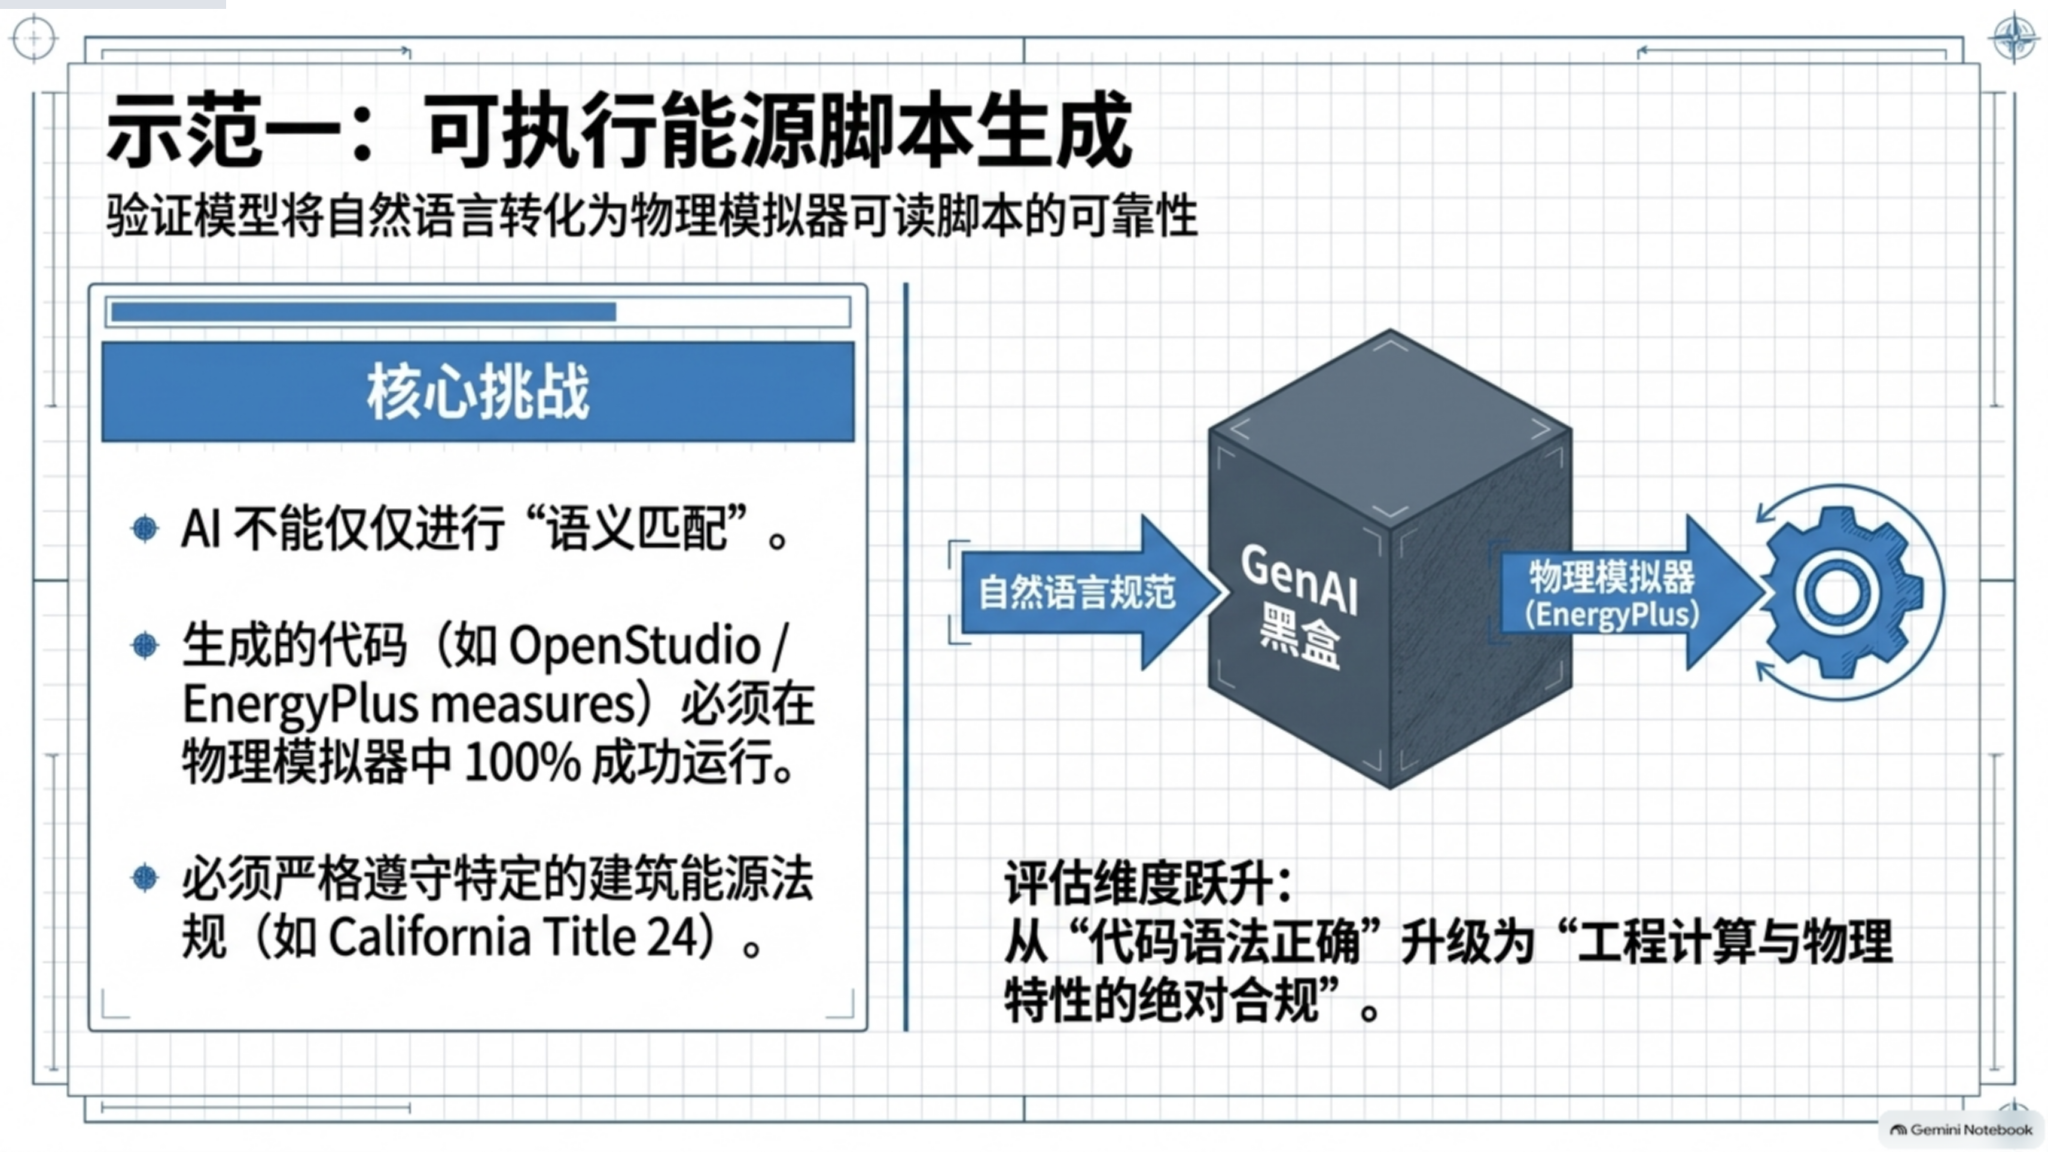
现状与痛点:目前大模型开发商普遍依赖计算机科学中的“闭环数据切分(Train/Test Split-Testing)”进行自我验证。
但这只能证明模型在已知数据集内的表现,无法检验其面对真实工程中复杂、未见的异构场景时的泛化能力。
面对市场上宣传高准确率的 GenAI 工具,工程师不知道该信任哪个指标。缺乏包含物理规律和规范符合度的标准,盲目将工具应用于工程计算,可能引发严重的结构安全与法律责任风险。
对学术界与研发者(论文作者 / AI 开发者):
现状与痛点:缺乏公认、具备说服力的权威基准(Baseline)。
开发者提出了新的 Prompt 策略或 Agent 架构,却不知道用什么指标才能证明自己的方法更好。大家只能各自在小范围的自建数据集上“自娱自乐”刷分,导致研究成果难以互相比较、难以复现,阻碍了整个 AEC AI 领域的持续创新与技术迭代。




声明:本网站内容版权归许鹏教授课题组所有。未经本课题组授权不得转载、摘编或利用其它方式使用上述作品。